評価と証拠
印象ではなく、証拠を採点する。
確認者に、元の回答、同じ文章化された基準、そして判断を記録する明確な場所を渡します。すべてのスコアは、それを支える仕事とつながったままです。
AI は要約と提案ができます。スコアを記録するのは記名された評価者で、決めるのは人です。
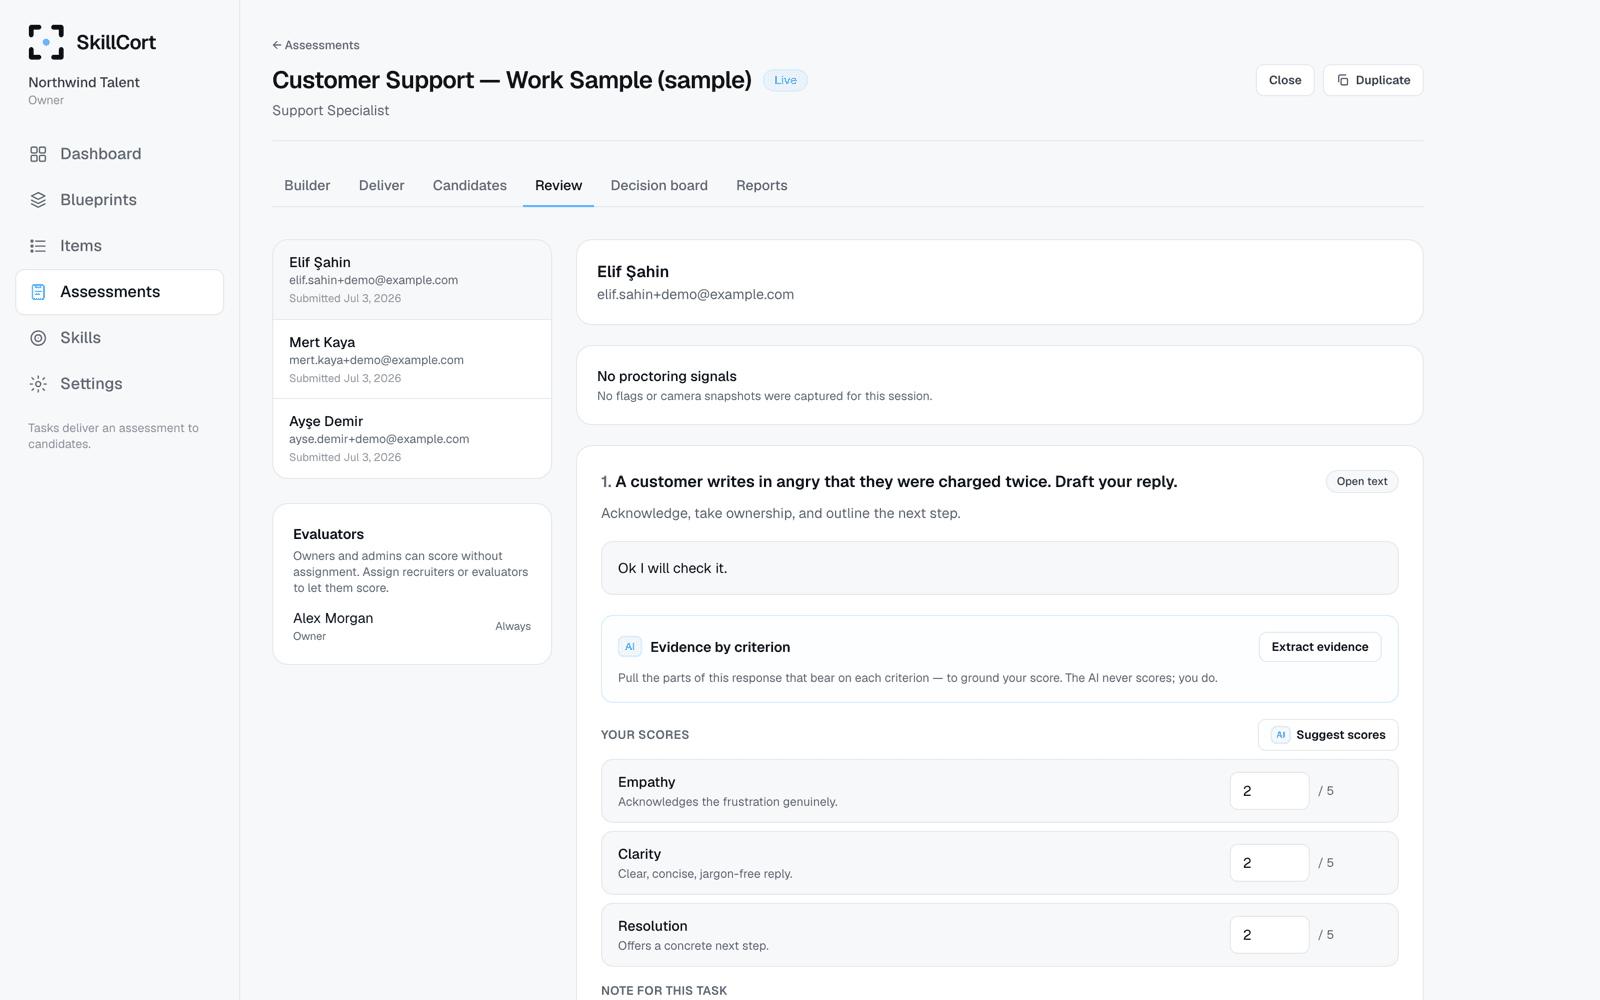
基準と裏づけが一緒に置かれた、確認のワークスペース
仕事に合う、記述された水準を選びます。
マトリクス型の評価ルーブリックは、各基準に水準ごとの文章による記述を組み合わせます。確認者は、数字を各自の解釈で当てはめるのではなく、実際に見て取れる行動を選びます。
- 基準×水準の記述
- 観察できる採点の目安
- 明示された基準の重み
- 評価者の間で共有
合う場面では、数値を直接入力できます。
クラシック型の評価ルーブリックは、同じ基準の構造と重みづけを保ちながら、評価者が数値のスコアを直接入力できるようにします。
- 基準ごとの数値スコア
- 基準の定義
- 重みづけによる合成
- 評価者のメモ
自動採点と人による採点のルールを、明示したまま保ちます。
解答キーつきの設問は自動でスコアを出せます。解答キーのない回答は未採点のまま確認を待ちます。職務適合度の集計では、人が付けた評価ルーブリックのスコアが得られる場合、その課題の自動的な適合度に代えて使われます。
- 解答キーによる採点
- 未採点は「要確認」であって、ゼロ点ではありません
- 得られる場合は評価ルーブリックのスコアを職務適合度に使用
- 採点方法はビルダーで確認できます
独立した判断を、誰のものかわかる形で保ちます。
同じ回答を複数の評価者が採点できます。各スコアは記名された評価者と時刻とともに保存され、重みが適用される前に基準ごとに平均されます。
- 記名された評価者への帰属
- 時刻の入った採点
- 基準ごとの平均
- 個々の判断は見える状態で残ります
候補者の仕事を、正となる出典として保ちます。
記述の回答、アップロードされたファイル、録音・録画、面接やシミュレーションの書き起こしは、要約に置き換えられることなく、確認のために残ります。
- 記述課題の成果物
- アップロードされた成果物
- 音声と動画の回答
- 面接とシミュレーションの書き起こし
理由づけを、スコアのそばに残します。
メモは課題の評価に添えられるため、確認者は何を見て取ったのか、なぜその仕事が特定の基準や水準に当てはまるのかを説明できます。
- 課題単位の確認メモ
- 数字のそばに置かれる理由づけ
- 記名された確認者の文脈
- 確認の記録から参照できます
セッションのイベントを、スコアに変えずに確認します。
不正防止の制御が有効なとき、そのイベントは別の時系列として表示されます。その文脈を解釈するのは確認者であり、イベントが自動でアセスメントのスコアを下げたり候補者を不合格にしたりすることはありません。
- 確認できるイベントの時系列
- 出典となる証拠を添えたまま
- スキルの採点とは切り離し
- 人による決着
証拠を、引き継ぎの場まで運びます。
印刷できるレポートが、採点、確認者の文脈、不正防止の決着、そして人が下した最終的な決定をまとめます。確認者は、元の媒体や対話の証拠を見るためにワークスペースへ戻れます。
- 印刷できる結果のまとめ
- 重みづけによる採点の方法
- 確認者への帰属
- 決定と不正防止の文脈
判断を明け渡すことなく、AI で読む時間を減らします。
証拠の抽出
AI は、長い回答の中から関係する箇所を評価ルーブリックの基準に沿って整理し、確認者が精査できるようにします。
スコアの下書きの提案
基準ごとの提案は、人が明示的に適用するか置き換えるまで、評価者のスコアの外側にとどまります。
書き起こしの確認
面接とシミュレーションの支援は、書き起こしに残る候補者の言葉に基づくものであり、表情や声の感情に基づくものではありません。
生成の来歴
AI が支援した評価の出力には、モデルとバージョンの来歴が付くため、あとからその工程をたどれます。
回答から職務適合度まで、どの段階も説明できます。
評価は抽象的なスコアからではなく、回答から始まります。確認者は固定された評価ルーブリックのスナップショットを適用し、基準ごとの判断を記録し、課題の証拠とともにメモを残します。
評価者のスコアは基準ごとに平均され、基準は評価ルーブリックの重みで合成され、課題の証拠はスキルとセクションの重みを通って職務適合度へ集約されます。意思決定ボードはその結果を、どう作られたのかを隠さずに比較できます。
候補者の比較を見る回答を開く
候補者の元の仕事と、その課題の背景を読むか再生します。
評価ルーブリックを当てる
共通の定義または水準の記述に照らして、各基準を採点します。
理由づけを記録する
判断がスコアとともに残るよう、評価者のメモを添えます。
透明に集約する
明示された重みを使って、基準、スキル、セクションを合成します。
確認を一貫させ、精査できるようにする評価の仕組み
共通の評価ルーブリック
クラシック型とマトリクス型の評価ルーブリックが、すべての評価者に同じ基準と明示された重みを与えます。
出典となる証拠
元の回答、ファイル、録音・録画、書き起こし、メモは、確認のワークスペースに残ります。
記名された判断
スコアは、それを記録した評価者と提出された時刻とともに保存されます。
支援としての AI
要約とスコアの提案は確認者が見当をつける助けになります。単独で決めたりスコアを書いたりすることはありません。
ばらばらの意見から、確認できる判断へ
構造のない評価
- 根拠の見えない、ひとつのスコア
- 別のツールに置かれた確認者のコメント
- 候補者ごとに異なる基準
- 答えとして扱われる AI の出力
- 元の仕事へ戻る明確な道筋がない
SkillCort の評価と証拠
- 共通の評価ルーブリックに結びついた基準ごとのスコア
- 回答のそばに残るメモ
- 記名された評価者と明示された重み
- 人のスコアから切り離された AI の提案
- すべての結果が出典となる証拠までたどれます
説明できるスコアは、計算が一貫しているだけのものではありません。その基準、証拠、担い手のすべてを精査できる判断のことです。
AI は、線の確認者側に置き続けます。
AI は長い回答や書き起こしを読み通す道のりを短くできますが、SkillCort は提案を評価者のスコアから構造的に切り離しています。提案を適用するか置き換えるかは人が行い、候補者についての決定は人のものであり続けます。
- AI が書いた候補者の決定はありません
- 自動的な不合格はありません
- 元の回答は見える状態のまま
- 基準ごとの提案
- 人が適用するか置き換える工程
- モデルとバージョンの来歴
評価と証拠についてのご質問
クラシック型の評価ルーブリックは、基準ごとに数値のスコアを受け付けます。マトリクス型の評価ルーブリックは、基準と水準の組み合わせごとに文章の記述を持つ、採点される水準を定義します。どちらも基準の重みと評価者のメモに対応しています。
複数の評価者のスコアは、基準ごとに平均されます。その基準ごとの平均が評価ルーブリックの重みで合成され、そのあと課題が対応づけられたスキルとセクションの重みを通って集約されます。
その設問は未採点のまま残り、確認が必要になります。黙ってゼロ点として扱われることはありません。職務適合度の集計では、両方が得られる場合、その課題の自動的な適合度に代えて、人が付けた評価ルーブリックのスコアが使われます。
いいえ。AI は基準ごとの提案や要約を下書きできますが、評価者のスコアや候補者についての決定を単独で書くことはありません。証拠を確認して判断を記録するのは、記名された人です。
課題によりますが、確認のワークスペースには、記述の回答、アップロードされたファイル、音声や動画の回答、面接とシミュレーションの書き起こし、評価者のメモ、評価ルーブリックのスコア、そしてそれらの制御が有効だった場合は不正防止イベントの別の時系列を含められます。印刷できるレポートは、あらゆる媒体を埋め込むのではなく、決定の記録をまとめます。